本文目录
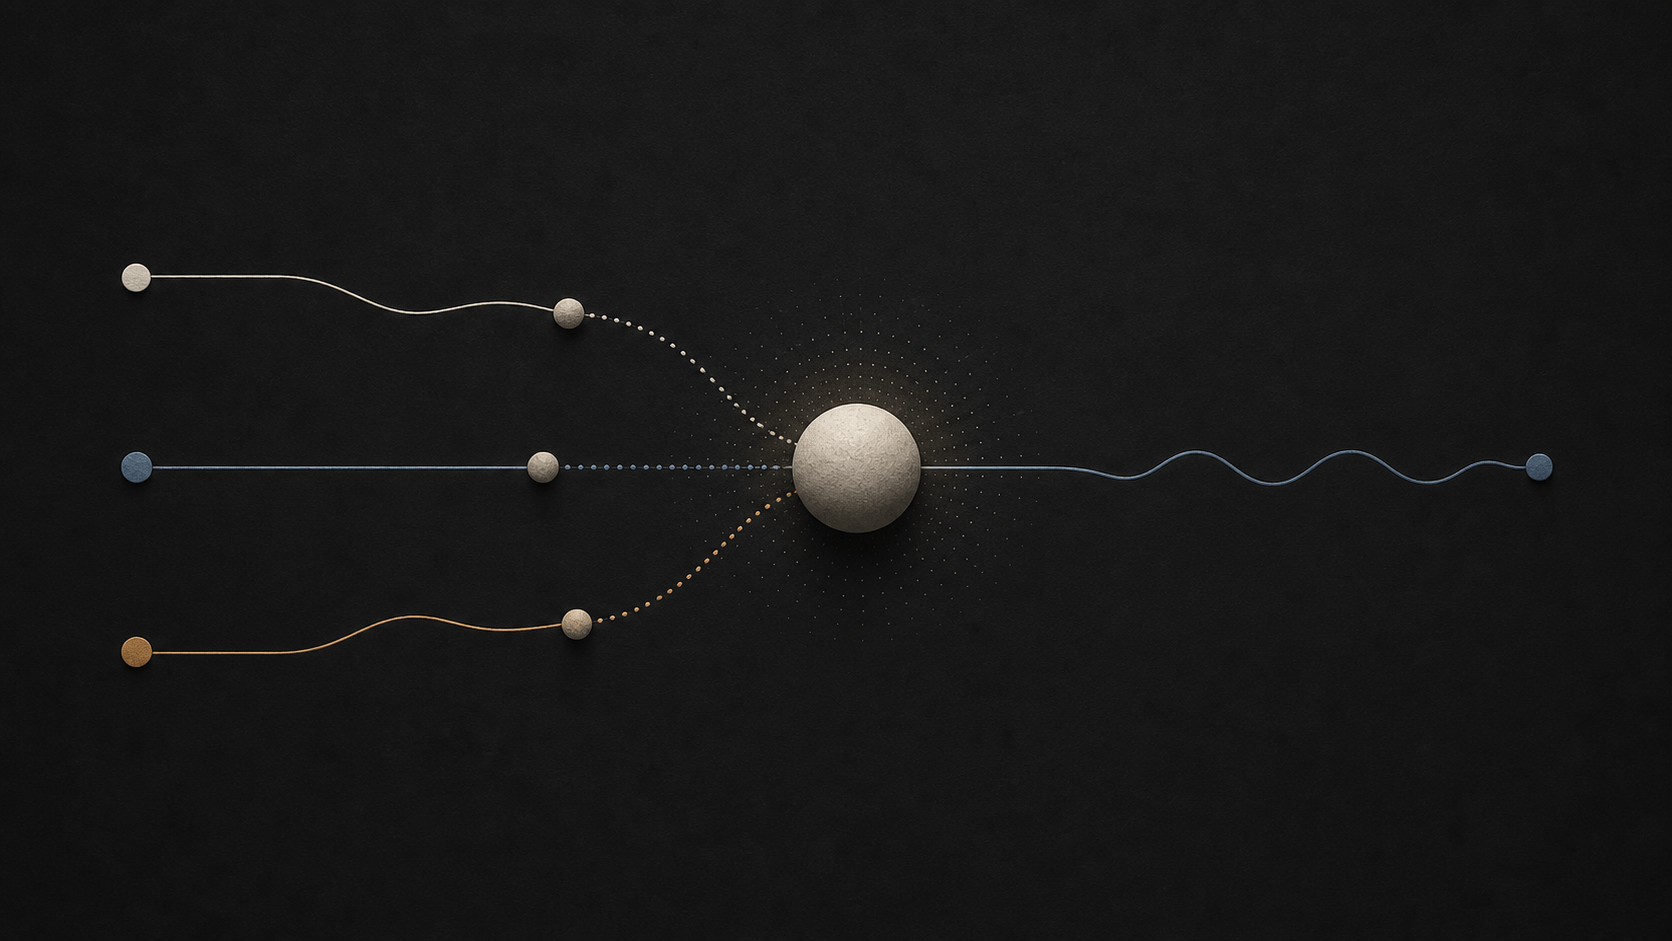
先别背公式。把下面的三个输入、三条权重和一个偏置都拖一拖,再按播放:动画会用白话一步步演给你看,公式最后才拼出来。有时结果会从负数跳到 0,有时只改一点点,输出却立刻变大。这个小实验台就是一个神经元在做的事,没有额外魔法。
可操作实验
调一调输入、权重和偏置,看神经元如何得出结果
这是一个神经元的前向计算:每路输入×权重 → 乘积合计 → 加偏置得到 z → ReLU 得到输出。不是整张网络;网络里可以有很多个这样的单元并行。
乘积合计
-1Σ(x×w)
加偏置 b=0.5 → z=-0.5
ReLU 把负数截成 0
精确数值
左侧是输入 x,紧挨着是权重 w。每一路先算 x × w。
z = Σ(xᵢ × wᵢ) + b · 输出 = ReLU(z) = max(0, z)
中间球是加偏置前的乘积合计;书上的加权和 z 是加完 b 之后。这只是一个神经元。
当前:每一路先乘一下 拖调节盘或改下方精确值后可重播;下一步会看到光线接到节点。
你刚才碰到的每一个数字,都有名字。它们听起来像术语,其实只是把一次算账拆开描述。
一个神经元的计算步骤
一个神经元拿到上一层传来的几个数,先分别乘上自己的权重,全部相加,再补上一个偏置,最后把结果交给激活函数。写成式子是:
这里的 z 是还没过激活函数的结果;f 表示激活规则。上面实验台用的是 ReLU(修正线性单元),不是教材里常写成 σ 的 Sigmoid:它直接取 0 和 z 里较大的那个。
先看默认值。它并不需要你相信任何抽象解释:
x1 × w1 =  1 ×  0.5   =  0.5
x2 × w2 =  2 × -0.25  = -0.5
x3 × w3 = -1 ×  1     = -1
--------------------------------
加偏置前                  = -1
再加 b = 0.5              = -0.5
ReLU(-0.5)                = 0
默认输出是 0,不是因为这个神经元“坏了”,而是这一次的合计没有跨过 ReLU 的门槛。把偏置往上调,或者让某个正向输入拿到更大的正权重,z 就可能变正,输出也会跟着出现。
先认清这些数各自扮演什么
**标量(scalar)**就是一个单独的数,例如 2、-0.25、0.5。实验台上的每个格子里都是标量;一排有顺序的标量才叫向量。先把这个区分清楚,后面看到矩阵时不会把“一整个对象”和“里面的一个数”混在一起。
输入(input) xᵢ 是神经元此刻收到的数字。它可能来自原始数据,也可能来自前一层已经算好的输出。输入本身不负责“该放大还是忽略”,它只是把当前可用的信号递过来。
权重(weight) wᵢ 是每条连接上的可训练数字。它决定这一路输入在合计里推向哪个方向、推多大力:正权重让正输入更容易拉高结果,负权重则会把正输入往下拉。别把它理解成固定的“重要程度排名”。同一个输入是正是负、其他输入在做什么,都会改变最终合计。
偏置(bias) b 是每个神经元自己的额外数字,不属于某一条输入线。它像是把整台小秤的零点挪了一下。即使所有输入都是 0,偏置仍然可以让结果是正、负或正好为 0。没有偏置,许多线性边界会被迫穿过原点,模型能表达的情况会更受限。
**加权和(weighted sum)**就是 ∑ᵢwᵢxᵢ+b。名字很直白:每项输入先按自己的权重处理,再统一求和,最后加上偏置。实验台故意把“加偏置前”和“加上偏置后”分开显示,是为了让你看到偏置不是一条神秘的新输入线;它在所有乘积求完和后只加一次。
ReLU 不是“算最大值的神经元”
ReLU 的全称是 Rectified Linear Unit,常译为修正线性单元。它的规则很短:
如果加权和是 3.2,输出仍是 3.2;如果是 -0.5,输出变成 0。所以说“正数时神经元被激活”是一个有用的口语说法:它表示这次计算有正的信号传给下一层。可别把它理解成某个永久开关。下一次输入不同,即使权重和偏置不变,这个神经元的输出也可能换成 0。
ReLU 只是激活函数的一种。二分类输出处常见 Sigmoid,多分类输出处常见 Softmax;它们承担的任务不同。这里选 ReLU,是因为它能把“门槛”这件事直接暴露出来,适合第一眼观察。
权重不是每次输入都重新抽一套
这点很容易被“模型会注意不同内容”带偏:训练好的模型在推理时,权重不会因每次输入而重新分配。
你给同一个已经训练好的网络两段不同文字,模型会得到不同输出,是因为输入数值变了,沿途每个神经元的加权和也随之变了;不是因为模型现场给某个神经元换了新权重。像实验台一样,权重和偏置不动时,同一组输入永远会算出同一个结果。
真正修改权重和偏置发生在训练阶段。模型先用当前参数计算预测,再把预测和标准答案比较;之后才有一套算法决定这些参数应该朝哪个方向挪一点。那是后面要讲的损失、反向传播和梯度下降。现在先把界线画清:
训练:权重和偏置会被逐步更新
推理:固定权重和偏置,换不同输入重新计算
为什么一个神经元还不够
如果整张网络只剩这一个神经元,它无论怎么调权重和偏置,本质都在做“加权求和,再过一个固定规则”。这已经能做不少判断,却还不足以表达复杂世界里的层层组合。
神经网络的做法不是让某一个神经元变得特别玄,而是把很多这样简单的计算单元排成层:上一层输出一串数,下一层的每个神经元再各自做一次 ∑wᵢxᵢ+b 和激活。每个单元的参数不同,因此它们会对同一批输入作出不同响应。
当你看到“某些神经元对某个输入更敏感”时,可以先翻译成这句话:在当前输入下,它那组权重、偏置和激活函数算出来的值更大。这里没有一位工作人员临时给它派活;它只是恰好拥有一组已经训练出来的参数。
把实验台当作一张检查清单
以后看到一个神经元公式,先不要急着把符号全部代进去。按这个顺序读更稳:
- 有几路输入,每一路的
xᵢ是多少? - 每一路对应哪个
wᵢ,乘积是正还是负? - 所有乘积相加后是多少?
- 偏置
b把结果往上或往下推了多少? - 最后的激活函数对这个数做了什么?
你可以在上面的计算器里专门试两个极端:把偏置设为 -3,观察 ReLU 如何频繁输出 0;再把它设为 3,观察门槛怎样被大幅放低。它们不是“好参数”或“坏参数”的固定标签,只是在说明参数会如何改变一次计算。
此刻最值得留下的,是一幅可操作的画面:三条输入线分别被自己的权重改变,合计后由偏置微调,最后在 ReLU 的门前决定是否留下正信号。后面的层、矩阵与 Transformer,只是把这件事在更大的规模上重复、并行和组合。