本文目录
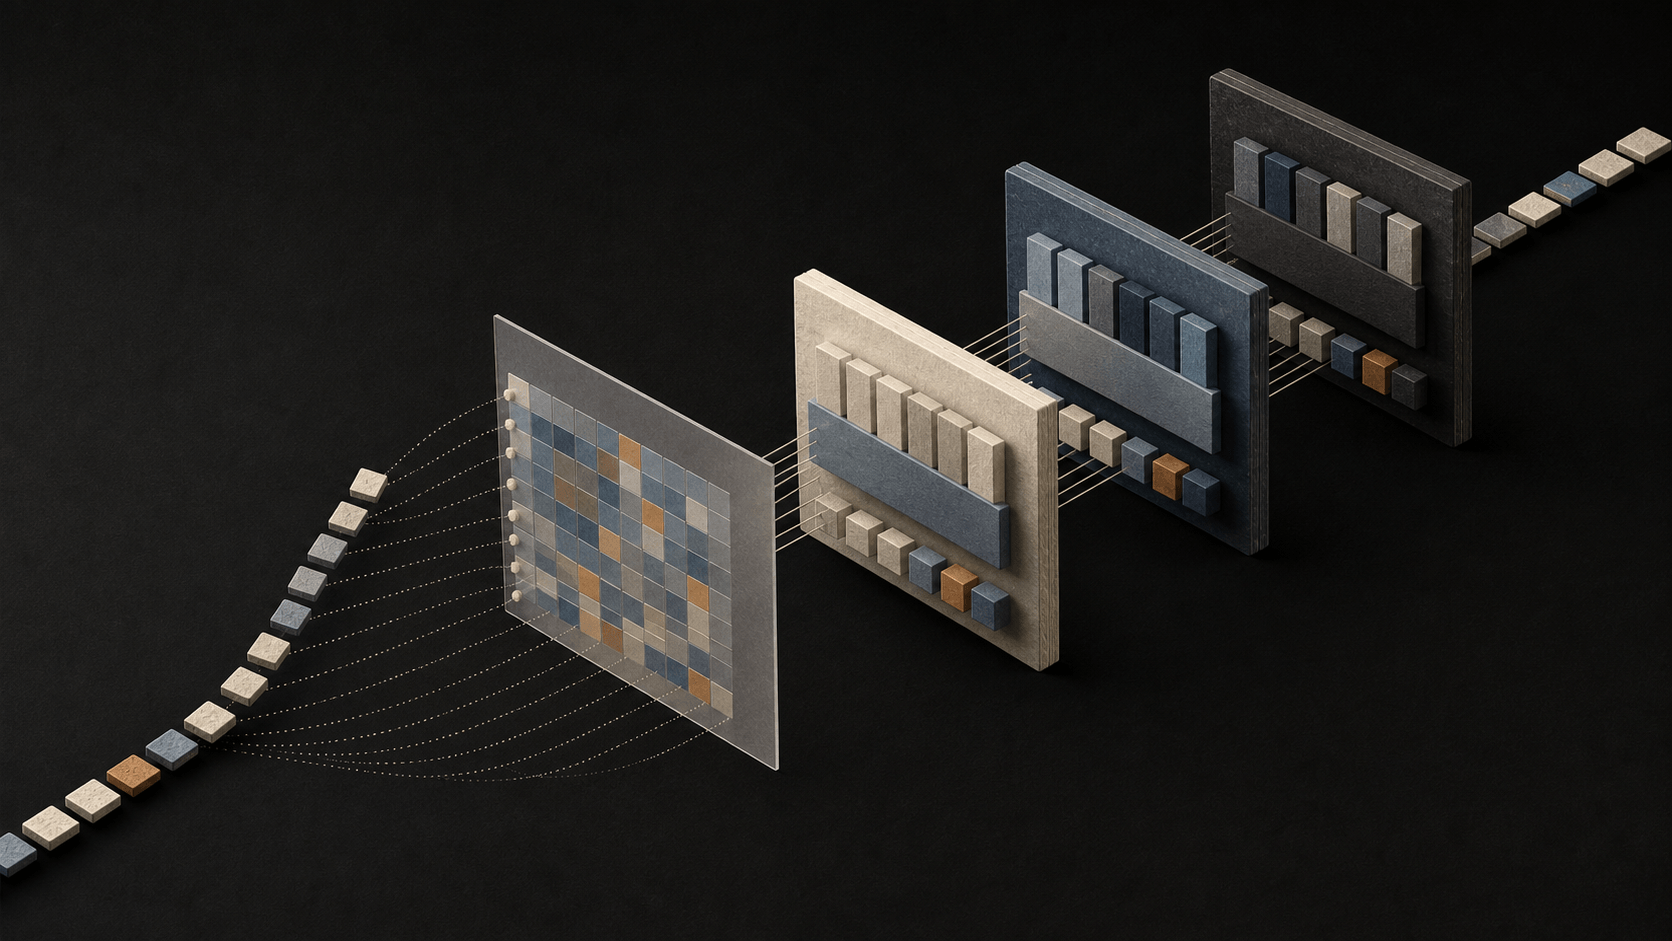
观察“人工智能”的切分过程
BPE 合并台
看字符怎样一步步合并成 Token
默认从「人工智能」开始。点「下一次合并」,相邻单位会按规则滑到一起。
从字符开始:每个字先各自成为一个 Token。
- 规则 1人 + 工 → 人工
- 规则 2人工 + 智能 → 人工智能
Token(词元)是模型处理文本的基本单位。它不必等于一个字,也不必等于一个完整单词。Tokenizer(分词器)按照 Vocabulary(词表)把文本切成 Token,再将每个 Token 映射成 Token ID——一个整数编号。
上面的简化实验从单字开始,依次应用合并规则。真实模型的词表更大,规则也更多,但重要逻辑一样:规则决定切法,文本本身不会天然携带唯一切法。
BPE 在优化什么
BPE(Byte Pair Encoding,字节对编码)反复合并训练语料中高频的相邻单位。常见片段可以用较少 Token 表示,罕见内容仍能退回到更小单位,不必为每个新词增加一个专属词条。
因此“中文一个字就是一个 Token”不是可靠规律;数字、标点、空格和罕见汉字都可能改变切分。
Token 数量为什么重要
上下文长度(Context Length)通常按 Token 计数,不按汉字数或页数。所谓“一百万上下文”表示一次请求中输入与输出合计可容纳的 Token 上限量级。它和参数量是两个指标:参数量是模型中可训练数字的总数,上下文长度是这次计算能放入多少 Token。
下一篇会继续追问:Token ID 只是编号,编号怎样变成可计算的语义表示?
Token ID 为什么不是字符编码
Token ID 只是某个词表版本里的索引。例如编号 872 可能对应“学习”,但换一个 Tokenizer 或换一版词表,同一个编号完全可能对应别的内容。因此 Token ID 本身没有大小关系:编号 900 不表示比编号 100“语义更多”,也不能拿两个 ID 相减来计算词义距离。
字符编码解决的是文字如何存储;Tokenizer 解决的是模型用什么单位读取文字。文本先按 Unicode 等编码存在文件里,进入模型前才由 Tokenizer 转成一串词表编号。两者都把文字变成数字,但用途和规则不同。
空格、标点和数字为何会改变切分
很多词表会把前导空格、常见标点组合甚至数字片段收入 Token。于是 "AI"、" AI" 和 "AI!" 不一定得到相同切法。英文里词根和后缀可能被分开,中文高频词可能合成一个 Token,代码中的缩进和符号也可能占用多个 Token。
这解释了两个看似奇怪的现象:字数相同的两段话,Token 数可能差很多;肉眼只改了一个空格,后续 Token ID 序列却可能整体变化。估算上下文时,最可靠的方法始终是使用该模型对应的 Tokenizer 实际计算。
BPE 训练与模型训练不是同一件事
BPE 训练先统计语料中的相邻单位频率,反复选择高频组合加入词表,最终得到固定的切分规则。语言模型训练则读取已经切好的 Token 序列,通过预测下一个 Token 更新神经网络参数。
前者决定“文本被拆成哪些零件”,后者学习“这些零件在上下文中如何组合”。Tokenizer 固定后,日常推理通常不会为用户的新句子临时修改合并规则。交互实验把合并过程逐步展示,是为了还原词表构建的直觉,而不是说模型每次回答都重新训练一次 BPE。
词表大小会直接进入下一章的矩阵
假设词表有 V 个 Token,后续 Embedding 矩阵就必须有 V 行:第 i 行专门给 ID 为 i 的 Token。BPE 把高频片段收进词表,是在 V 与切分粒度之间做折中——词表太大,Embedding 吃内存;词表太小,同一句话会被切成更多 Token,更容易顶满上下文窗口。
拿上面实验里的“人工智能”做直觉:若词表已收录整词,可能只要 1~2 个 Token;若只收录单字,就会变成更长的 ID 序列。字数没变,占用的上下文预算却变了。所以估算提示词长度时,不能按汉字数心算,要用该模型配套的 Tokenizer实算。
Tokenizer 也是部署协议的一部分。权重、配置与词表必须同版本:错词表编出来的 ID,会被模型当成别的 Token 读入,后面再正确的神经网络也救不回来。下一章就从“编号 → 矩阵的一行”开始,把这里的 V 接到 Embedding 形状上。